Personal · 2026
Calificame
Calificación de exámenes con visión por IA y el docente en el circuito.
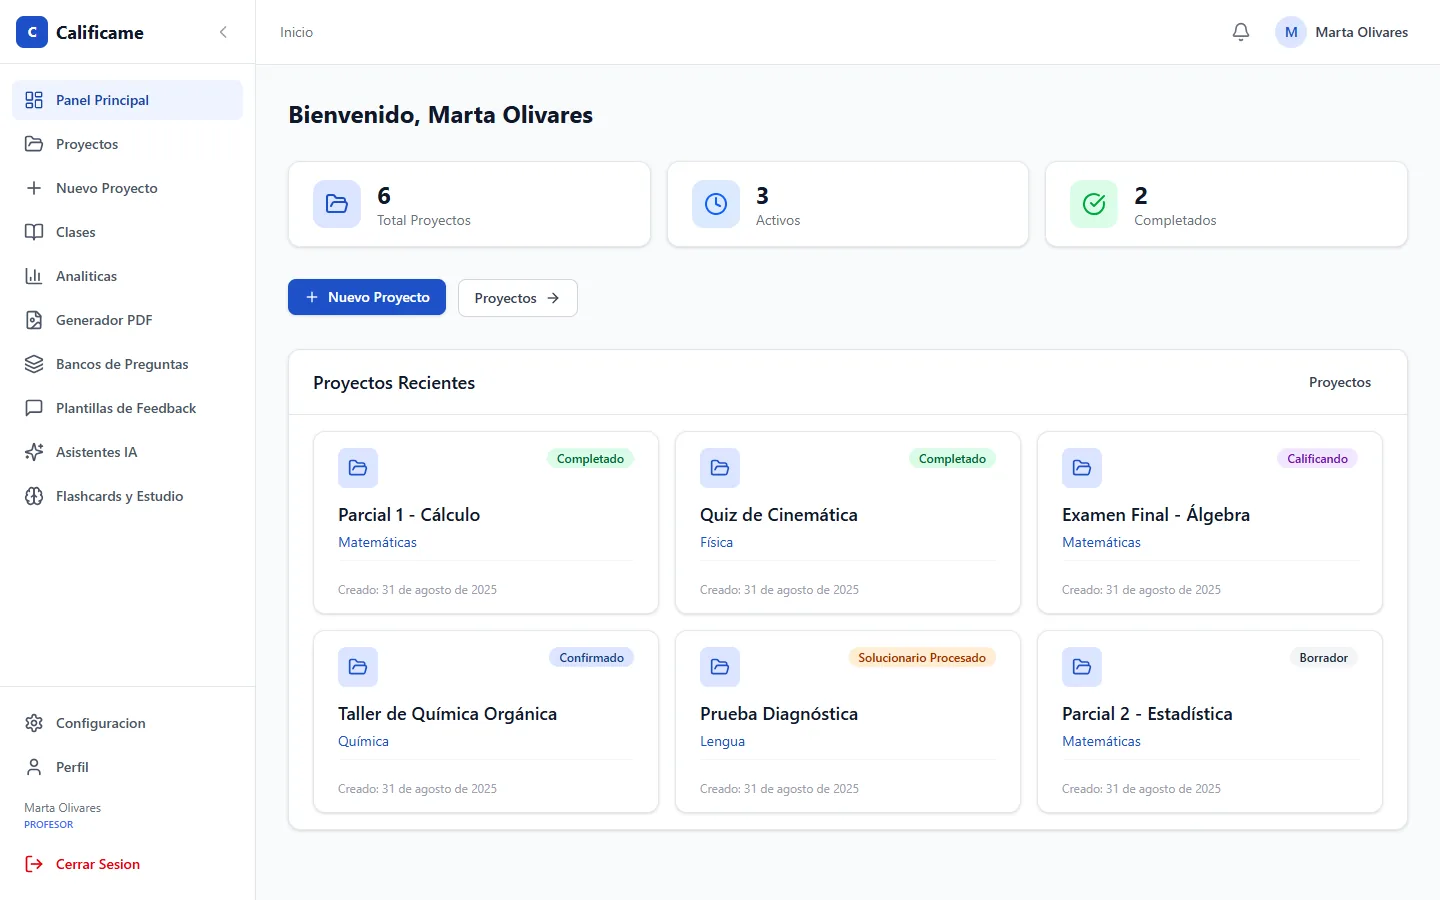
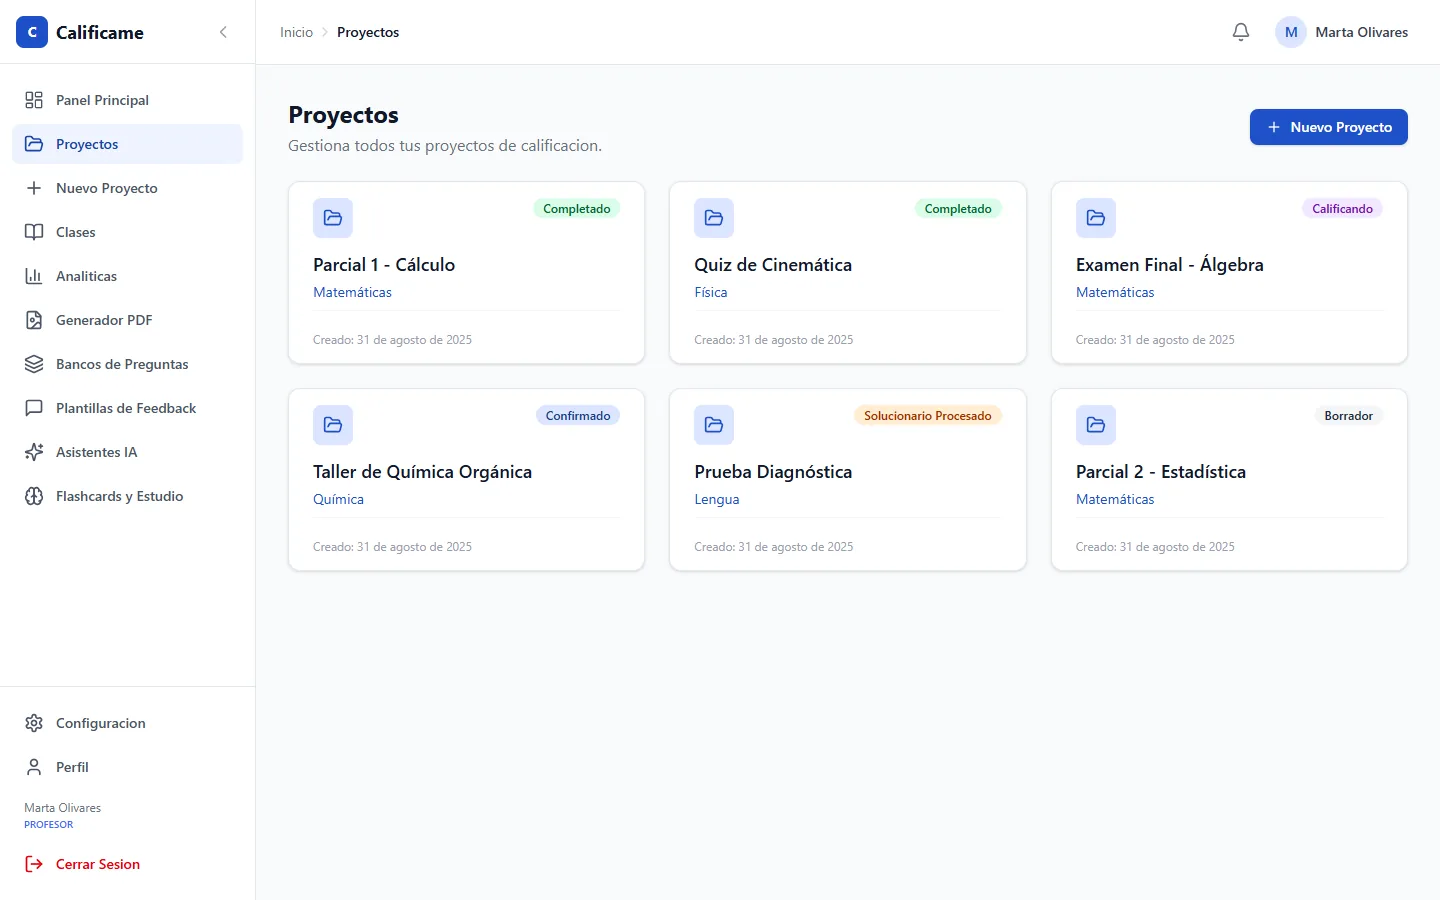
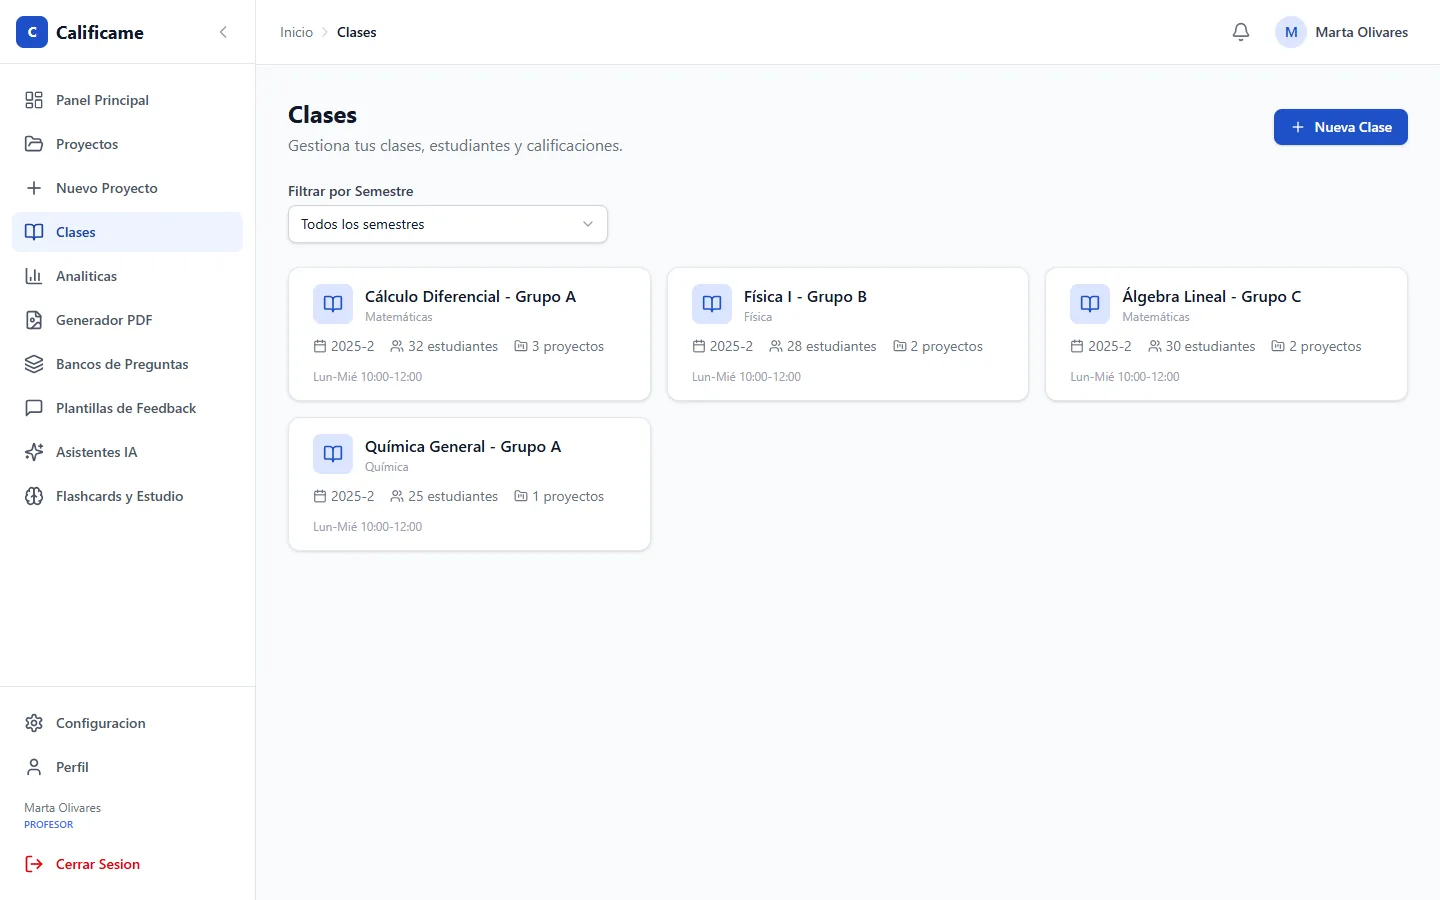
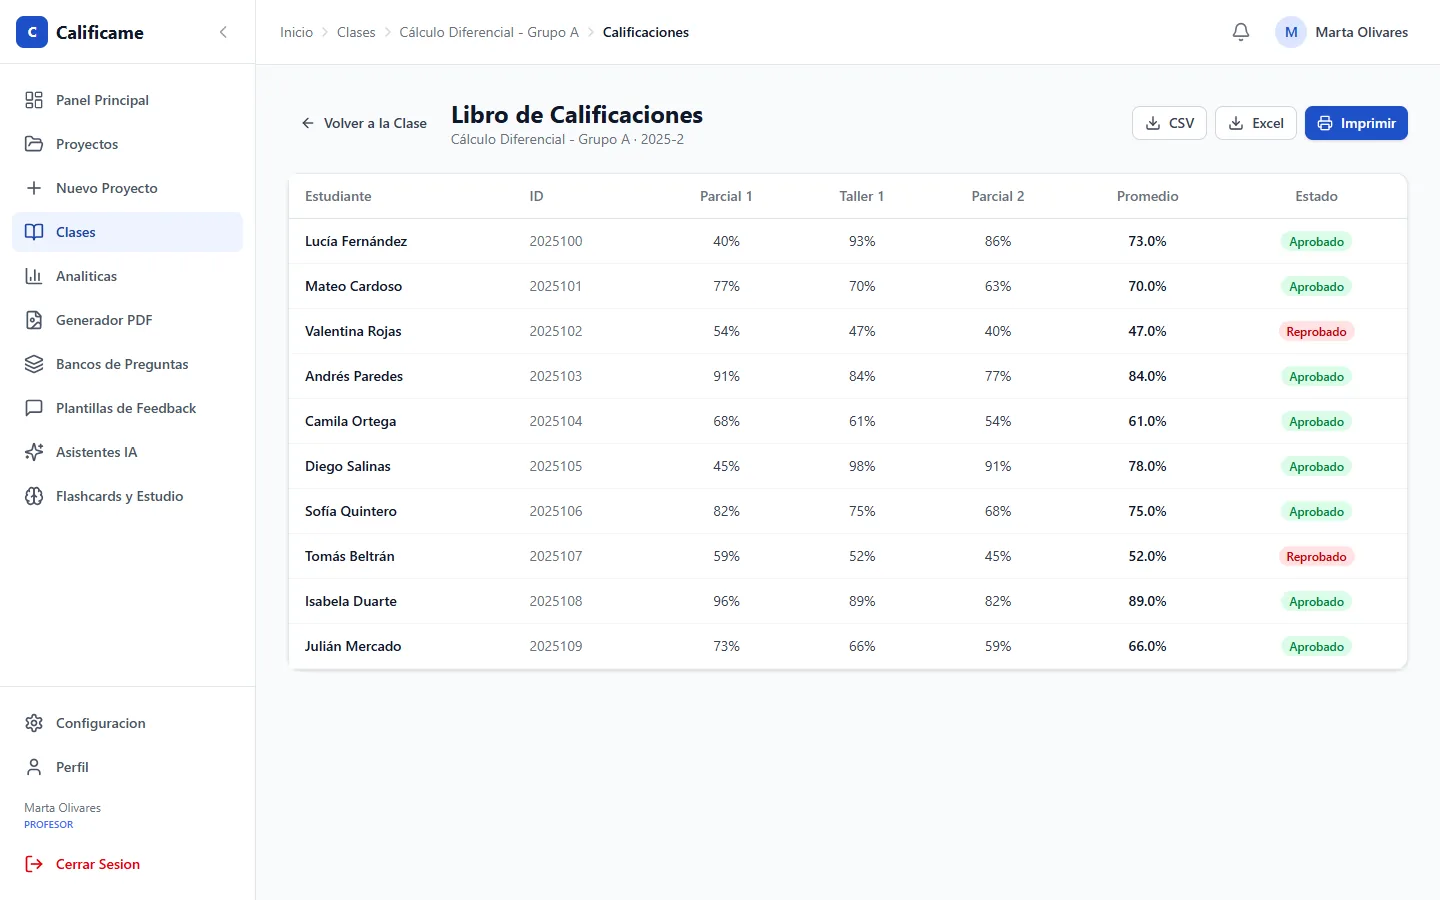
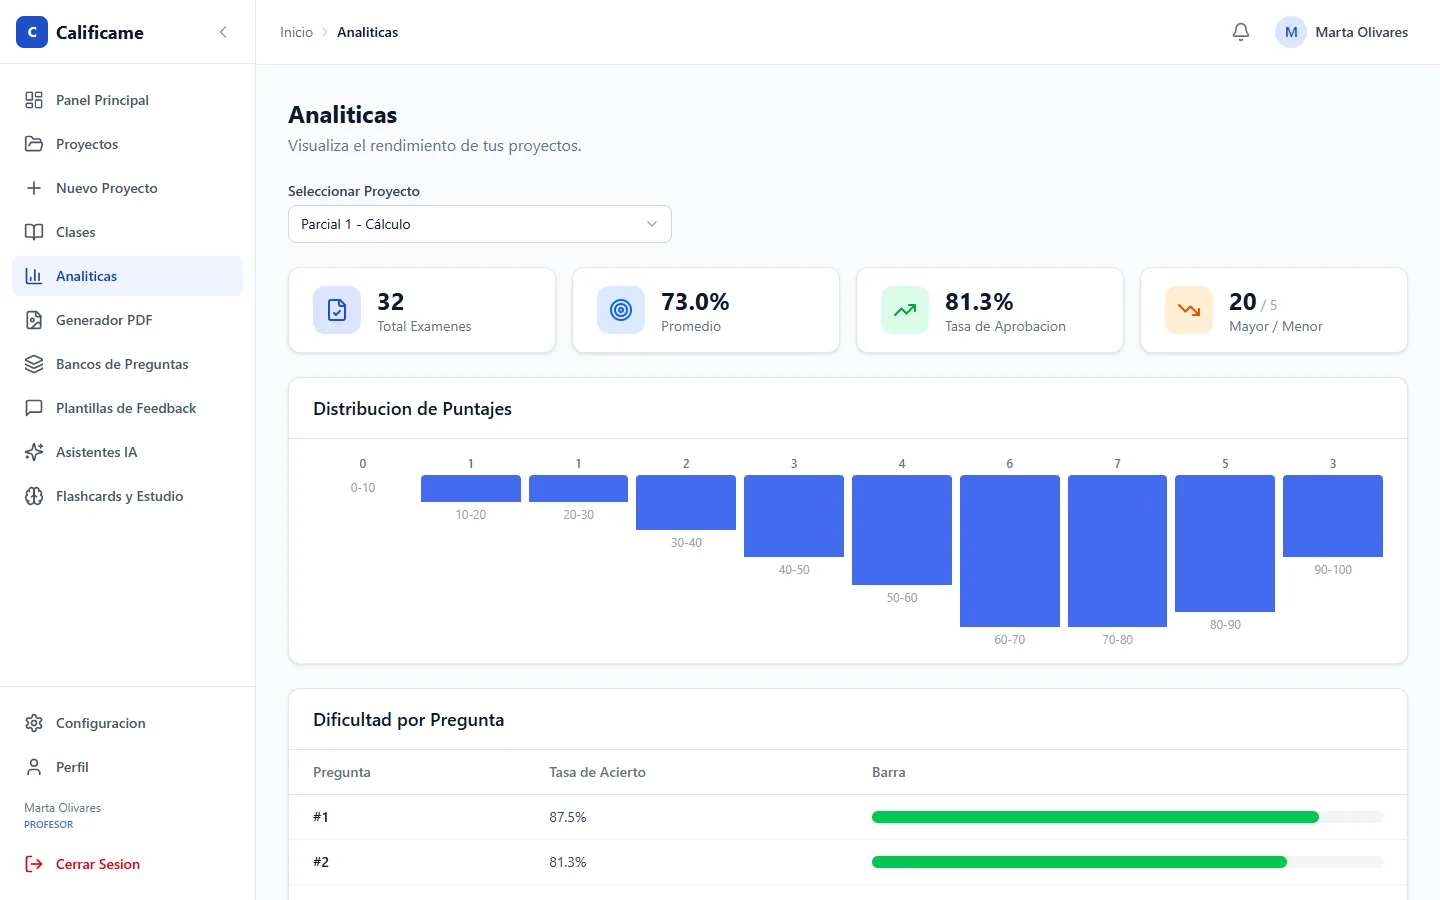
- 01
Un modelo de visión lee y califica con rúbricas
- 02
Confianza por pregunta y revisión del docente
- 03
Apelaciones y libro de notas
El problema
Calificar exámenes manuscritos consume horas de trabajo repetitivo del docente: leer cada respuesta, compararla con el solucionario, asignar crédito parcial y justificar la nota.
La solución, de punta a punta
- El docente crea una clase y sube el solucionario.
- El sistema extrae las preguntas con IA y el docente las revisa, las edita, las confirma y define rúbricas por pregunta.
- El docente sube los exámenes de los estudiantes (PDF o imágenes).
- Un modelo de visión lee las respuestas y califica según las rúbricas. Devuelve por pregunta la respuesta extraída, la nota, la retroalimentación y un nivel de confianza.
- El docente revisa y corrige las calificaciones.
- El estudiante puede apelar y el docente resuelve la apelación.
- Las notas pasan a un libro de calificaciones por clase, con resúmenes y exportación.
Arquitectura
Un frontend web habla con una API. Las calificaciones por lote corren como tareas asíncronas que llaman a un modelo de visión, y los resultados vuelven a la base de datos para que el docente los revise. Las apelaciones del estudiante entran al mismo circuito de revisión, y de ahí las notas pasan al libro de calificaciones y a los reportes.
Decisiones de diseño
- El modelo de visión es a la vez lector y calificador. No hay un OCR propio: el modelo recibe las imágenes del examen junto con el solucionario y produce un JSON estructurado por pregunta.
- Rúbricas por pregunta. El docente las define y el modelo devuelve el desglose por criterio, lo que hace explicable el crédito parcial.
- Confianza por pregunta. El modelo declara un valor entre 0 y 1 para cada respuesta. Es una señal autodeclarada, no una probabilidad calibrada; se muestra al docente como ayuda para decidir qué revisar.
- Docente en el circuito. Nada es definitivo sin que el docente pueda corregirlo, y existe un flujo de apelaciones.
- Estimación de costo. Hay una estimación por tokens del costo de cada calificación. Es una aproximación con tarifas escritas a mano, no una medición de gasto real.
Ingeniería
- Backend: FastAPI con SQLAlchemy y migraciones Alembic. La calificación por lote corre como tarea asíncrona con registro de estado y consulta periódica desde el cliente.
- Frontend: Next.js (App Router) con TypeScript y Tailwind.
- Modo MVP controlado por bandera: el producto tiene muchas más rutas que las expuestas; una variable de entorno reduce la aplicación al núcleo (clases, proyectos, libro de notas, generación de PDF y vista de estudiante) sin borrar el resto del código.
- Pruebas: pruebas unitarias y de integración en el backend, con el proveedor de IA simulado, y pruebas de extremo a extremo con Playwright en el frontend.
- CI: ruff, pytest y build de imagen en el backend; ESLint, type-check, build y Playwright en el frontend; y Dockerfile en cada repositorio.
Mi rol
Autor del 100 % de los commits sin merge del frontend y de la mayor parte de los del backend (el resto son de un bot de formato), según el historial de git, entre abril y mayo de 2026. Trabajé con desarrollo asistido por IA.
Lo que aprendí y qué cambiaría
- Falta medir la precisión. Aún no existe una evaluación del calificador frente a notas humanas. Es el siguiente paso más importante: construir un conjunto de exámenes anotados por docentes y medir la concordancia, y con ello calibrar si la confianza declarada sirve de verdad para decidir qué revisar.
- Datos de estudiantes. El sistema maneja información personal de estudiantes. Antes de cualquier uso real hay que definir consentimiento, retención y tratamiento por terceros.
- Alcance. El producto creció más rápido que su validación; el modo MVP lo acota al núcleo sin borrar el resto del código.